Поиск надежных партнеров и подрядчиков — классическая рутина для любого бизнеса. Недавно ко мне обратился один из моих давних клиентов (специализированный технический центр по ремонту автомобилей) с необычной для меня задачей, которую часто поручают штатным менеджерам или фрилансерам-лидогенераторам: собрать качественную базу потенциальных B2B-партнеров в Москве. С одним маленьким условием: для ускорения получения результата и повышения качества полученных данных — нужно было сделать это при помощи искусственного интеллекта.
Сложность задачи заключалась в двух жестких требованиях клиента, на которых спотыкаются стандартные сервисы (вроде 2ГИС или Яндекс Карт):
- Узкая специализация: нужны были не «все автосервисы подряд», а только монобрендовые техцентры, обслуживающие исключительно одну конкретную марку авто.
- Локация и ранжирование: бизнесы требовалось собрать как можно ближе к адресу компании клиента, а итоговый список строго проранжировать по мере удаления (от ближайших к дальним с точным указанием километража), чтобы в первую очередь наладить контакт с соседями по району.
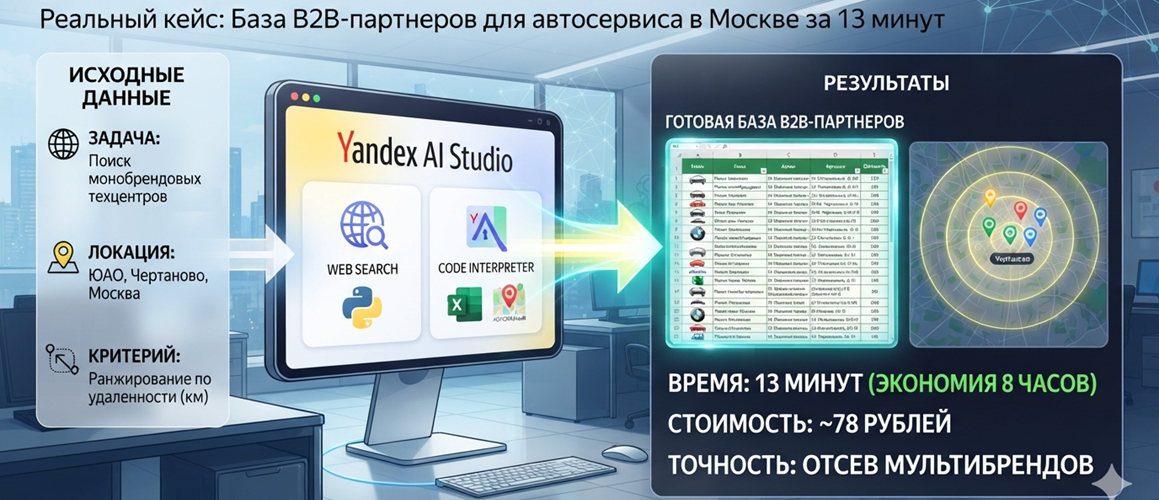
Вручную проверять специализацию сотен сервисов и замерять расстояние до каждого через навигатор заняло бы у сотрудника целый день. Я решил эту задачу для клиента всего за 10 минут своего времени + 3 минуты программной реализации, потратив на вычисления нейросети (детализация будет ниже) 78 рублей.
Ниже подробно рассказываю, как была выстроена архитектура решения, какие инструменты я подключил и как выглядит экономика подобной ИИ-автоматизации.
1. Постановка задачи от клиента
Исходные данные: Базовая локация клиента (офис/производство) находится на юге Москвы (ЮАО, район Чертаново).
Ключевые требования к итоговой базе:
- Строгая монобрендовость: сервис должен специализироваться только на одной целевой марке (клубные центры, профильные СТО, официальные дилеры). Мультибрендовые сервисы широкого профиля должны быть полностью отфильтрованы.
- Близость к локации и ранжирование по удаленности: ключевой критерий — находить техцентры с минимальным расстоянием от адреса клиента. Итоговый список в таблице должен быть строго отсортирован: на первых строках — ближайшие сервисы в шаговой/минутной доступности, далее — по мере нарастания километража.
- Проверка актуальности: только работающие компании с «живыми» сайтами и по возможности с прямыми ссылками на страницы контактов.
- Формат сдачи: готовая структурированная таблица Excel (
.xlsx).
2. Архитектура решения и настройки модели
Для реализации проекта я использовал платформу Yandex AI Studio, связку из быстрой модели DeepSeek и двух системных инструментов:
А. Инструмент Web Search (Веб-поиск)
Обычная нейросеть не знает актуального состояния рынка прямо сейчас.
- Я подключил веб-поиск и установил параметр Размер контекста поиска:
Medium. Это позволило модели искать, выкачивать и анализировать достаточное количество данных со страниц сайтов автосервисов для отсева мультибрендов, не раздувая расходы на входящие токены.
Б. Инструмент Code Interpreter (Интерпретатор Python)
Именно этот инструмент решил задачу точного ранжирования по расстоянию и создания файла XLS:
- Нейросети плохо считают километраж «в уме». Code Interpreter дал возможность модели прямо в процессе работы написать и выполнить Python-код.
- Скрипт рассчитал точное расстояние по координатам от точки клиента (адрес местоположения) до каждого найденного объекта, отсортировал массив данных строго по возрастанию дистанции и упаковал результат в файл Excel через библиотеку
pandas.
В. Настройка гиперпараметров модели: баланс точности, скорости и стоимости
Помимо подключения инструментов, критически важно было правильно выставить параметры самой генерации. Неверные настройки могли либо сломать генерацию файла, либо в разы раздуть бюджет и время выполнения.
- 1. Отказ от режима рассуждений (Reasoning / Thinking off):
Модели с глубокими «рассуждениями» тратят десятки секунд и тысячи токенов на внутренний монолог перед каждым действием. В нашей задаче логика была жестко заложена в промпт, а за сложные вычисления (расстояния, сортировку) отвечал Python. Отключение режима рассуждений позволило модели работать на максимальной скорости и сэкономило клиенту более 60% бюджета на токены. - 2. Минимальная температура (Temperature = 0.1 – 0.2):
Температура отвечает за вариативность и «креативность». В B2B-сборе данных креативность вредна: нам требовалась строгая детерминированность, исключающая любые галлюцинации, точное извлечение реальных URL-адресов и безошибочный синтаксис Python-скрипта. Низкая температура гарантирует соблюдение инструкций на 100%. - 3. Увеличенный лимит исходящих токенов (Max Output Tokens):
Сбор большой базы данных требует генерации объемного промежуточного кода для Code Interpreter и итоговой таблицы на десятки строк. Если лимит токенов на выходе занижен, модель может «обрезать» код на середине выполнения скрипта, что привело бы к ошибке создания Excel-файла. Лимит был выставлен с запасом (от 4000 до 8000 токенов), чтобы генерация завершилась корректно за один проход.
3. Инженерия поисковых запросов
Если просто дать ИИ команду «Найди мне сервисы такой-то марки поближе к Чертаново», поиск выдаст недостаточно качественный результат.
Чтобы закрыть требование клиента о сборе сервисов как можно ближе к его адресу, я с помощью другой ИИ-модели создал систему микролокационных запросов (по прилегающим шоссе, станциям метро и районам ЮАО/ЮЗАО), совмещенную с маркерами монобрендовости («клубный сервис», «специализированный техцентр»).
Промпт, который я запустил для сбора базы:
Базовый адрес: Россия, Москва, ул. такая та, дом такой-то (ЮАО, Чертаново).

Твоя задача — найти автосервисы, расположенные КАК МОЖНО БЛИЖЕ к базовому адресу, которые специализируются ИСКЛЮЧИТЕЛЬНО на марке [УКАЗАННАЯ МАРКА] (клубные, профильные, монобрендовые и официальные сервисы). Мультибрендовые СТО полностью исключить.

ИНСТРУКЦИЯ ПО ПОИСКУ (Web Search):
Используй последовательно следующие поисковые запросы для поиска объектов вокруг базовой локации:
- "клубный сервис [Марка]" Варшавское шоссе Чертаново ЮАО
- "специализированный техцентр [Марка]" ЮАО Москва
- профильный сервис [Марка] метро Южная Пражская Чертановская Нагатинская
- ремонт только [Марка] Варшавское шоссе Каширское шоссе
- монобрендовый автосервис [Марка] Москва Юг
- сервис [Марка] Москва Юг ЮАО Варшавка Аннино
- сервис [Марка] Москва метро Тульская
- сервис [Марка] Москва метро Нагорная
- сервис [Марка] Москва метро Варшавская
[- и т.п.]

АЛГОРИТМ ОБРАБОТКИ:
1. Из найденных вариантов отбери уникальные сервисы, проверив по их сайтам, что они специализируются только на [Марке]. Проверь сайты на доступность.
2. Для каждого сервиса извлеки: Название, Точный фактический адрес, Ссылку на сайт, Ссылку на контакты.
3. С помощью Code Interpreter:
   - Рассчитай точное расстояние от базового адреса ([адрес клиента]) до каждого сервиса в километрах.
   - Проранжируй (отсортируй) список СТРОГО по мере удаления: от самых близких к более дальним.
   - Сформируй Excel-файл (.xlsx) со структурой: [Название, Адрес, Удаленность (км), Сайт, Контакты].
4. Выведи результат в чат в виде таблицы и предоставь ссылку на скачивание Excel-файла.
4. Результаты, скорость и себестоимость
Спустя 3 минуты нейросеть завершила поиск, скрипт на Python (его тоже написала сама нейросеть) выполнил гео-расчеты, и в чате появилась ссылка на скачивание сформированного Excel-файла, содержащего данных нескольких десятков искомых бизнесов.
В файле первой строчкой шел сервис, расположенный буквально в 1 км от клиента, далее — сервисы на удалении 1.5 км, 2 км и так далее по нарастающей. Вся база состояла исключительно из целевых монобрендов с прямыми ссылками на контакты (я провел выборочную проверку и нашел результат вполне приемлемым).
Себестоимость решения (токены — стоимость):
| Параметр / Ресурс | Объем потребления | Стоимость |
|---|---|---|
| Кешированные токены | ~560k токенов | 42,00 ₽ |
| Токены вызова инструментов | ~127k токенов | 9,50 ₽ |
| Исходящие токены (генерация) | ~8.4k токенов | 4,20 ₽ |
| Веб-поиск (Web Search) | ~24 запроса | 22,00 ₽ |
| Сессия Code Interpreter | 1 сессия | 0,00 ₽ |
| ИТОГО: | — | 77,7 ₽ |
Какую выгоду получил бизнес клиента?
• Экономия времени: Менеджер клиента потратил бы на ручной сбор, проверку монобрендовости и расчет расстояний через карты до 8 часов.
• Экономия бюджета: ФОТ сотрудника на эту задачу составил бы от 3 000 до 5000 ₽. Затраты на генерацию через ИИ составили ~78 ₽.
• Идеальная логистика: Клиент сразу начал обзвон и встречи с партнерами, расположенными в радиусе 10–15 минут езды от его локации.
Вывод для бизнеса
Связка «Языковая модель + Веб-поиск + Интерпретатор кода» превращает нейросеть в полноценного цифрового аналитика. Она не просто «пишет текст», а самостоятельно ищет актуальные данные в сети, фильтрует их по сложным критериям, делает математические расчеты и отдает готовый файл для работы.
Аналогичным образом я настраиваю сбор данных под любые B2B-задачи:
- Поиск и ранжирование поставщиков, дилеров и подрядчиков в любых регионах.
- Мониторинг цен конкурентов по узким категориям товаров.
- Проверка, обогащение и гео-валидация клиентских баз данных.
Хотите автоматизировать сбор данных или рутинные процессы в вашей компании?
Если ваши сотрудники тратят драгоценные рабочие часы на ручной поиск информации в интернете, сведение таблиц или проверку контрагентов — напишите или позвоните мне. Я проанализирую ваши задачи и разработаю быстрое решение на базе ИИ с минимальной себестоимостью.
📩 Контакты для связи: https://leolukin.ru/kontakty/